Jev: a IA que decide em vez de escrever
O Jev, da TypeSafe AI, não escreve: devolve decisões com probabilidade. Entenda como funciona, o que os números dizem, onde usar e quais são os limites.
- Autor
- Gabrielly Vizzotto Cruz
- Publicado
- Leitura
- 11 min
- Palavras
- 2.190
Há anos a corrida da inteligência artificial gira em torno de quem escreve melhor: respostas mais longas, código mais limpo, conversas mais naturais. O Jev, lançado pela TypeSafe AI em 15 de setembro de 2026, vai na direção oposta. Ele não escreve uma frase sequer.
Em vez de gerar texto, o Jev devolve decisões: uma opção escolhida, uma nota, um sim ou não, sempre acompanhados de uma probabilidade. A proposta é servir ao software, não às pessoas. É a IA pensada para ficar dentro do sistema, decidindo para onde um chamado vai, se uma nota fiscal tem problema ou se um agente de IA está saindo dos trilhos.
Neste guia, você vai entender o que é o Jev, como ele funciona, o que os números de lançamento realmente dizem, onde ele faz sentido para empresas e quais são os limites apontados por especialistas.
O que é o Jev?
O Jev é o primeiro modelo público de uma categoria que a TypeSafe AI chama de System One Models: modelos de IA feitos para tomar decisões rápidas e estruturadas que um software consegue usar diretamente. A própria empresa o descreve como uma "chamada de função com inteligência de fronteira": entra um estado não estruturado, sai uma decisão tipada com probabilidade (TypeSafe).
A TypeSafe AI é um laboratório de São Francisco fundado em 2024 pelo CEO Diogo Almeida e pelos cofundadores Erik Gafni e Sasha Sheng. Almeida trabalhou na OpenAI em RLHF, InstructGPT, ChatGPT e GPT-4, os métodos que tornaram os modelos de linguagem bons em seguir instruções. Depois de dois anos em modo stealth, a empresa saiu do anonimato com uma rodada seed de US$ 40 milhões liderada pela DCVC, e a Forbes reportou uma avaliação de cerca de US$ 200 milhões (SiliconANGLE).
Um detalhe para quem for pesquisar: a TypeSafe AI não tem relação com a antiga Typesafe, empresa da linguagem Scala que virou Lightbend.
Sistema 1 e Sistema 2: a inspiração em Kahneman
O nome da categoria vem do livro Rápido e Devagar, de Daniel Kahneman. Nele, o Sistema 1 é o pensamento rápido e intuitivo, que responde quanto é 2 + 2 ou percebe irritação em uma voz sem esforço. O Sistema 2 é o lento e deliberado, usado para calcular 17 × 24 ou preencher uma declaração de imposto.
A TypeSafe aplica essa divisão à IA. Os grandes modelos de linguagem fazem o papel do Sistema 2: raciocinam, planejam e escrevem, mas levam segundos ou minutos. O Jev quer ser o Sistema 1 do software, com respostas em milissegundos para decisões que se repetem milhares de vezes.
Há uma diferença importante em relação ao livro. Para Kahneman, o Sistema 1 é justamente o mais sujeito a erros. A TypeSafe diz acreditar que seus modelos podem ser mais confiáveis que as alternativas, mas ainda não detalhou por quê.
Paradoxo de Jevons: por que o nome do modelo importa
O Jev homenageia o economista inglês William Stanley Jevons. Em 1865, no livro The Coal Question, ele observou que máquinas a vapor mais eficientes não reduziram o consumo de carvão na Grã-Bretanha. Pelo contrário: com o carvão rendendo mais, surgiram mais usos para ele, e o consumo total subiu. Esse efeito ficou conhecido como Paradoxo de Jevons.
A aposta da TypeSafe é que a inteligência artificial vai seguir o mesmo caminho. Se uma decisão de IA passa a custar frações de centavo, tarefas que nunca valeriam uma chamada de LLM passam a ser automatizadas. O resultado esperado não é gastar menos com IA, e sim usar IA em muito mais lugares.
Como o Jev funciona
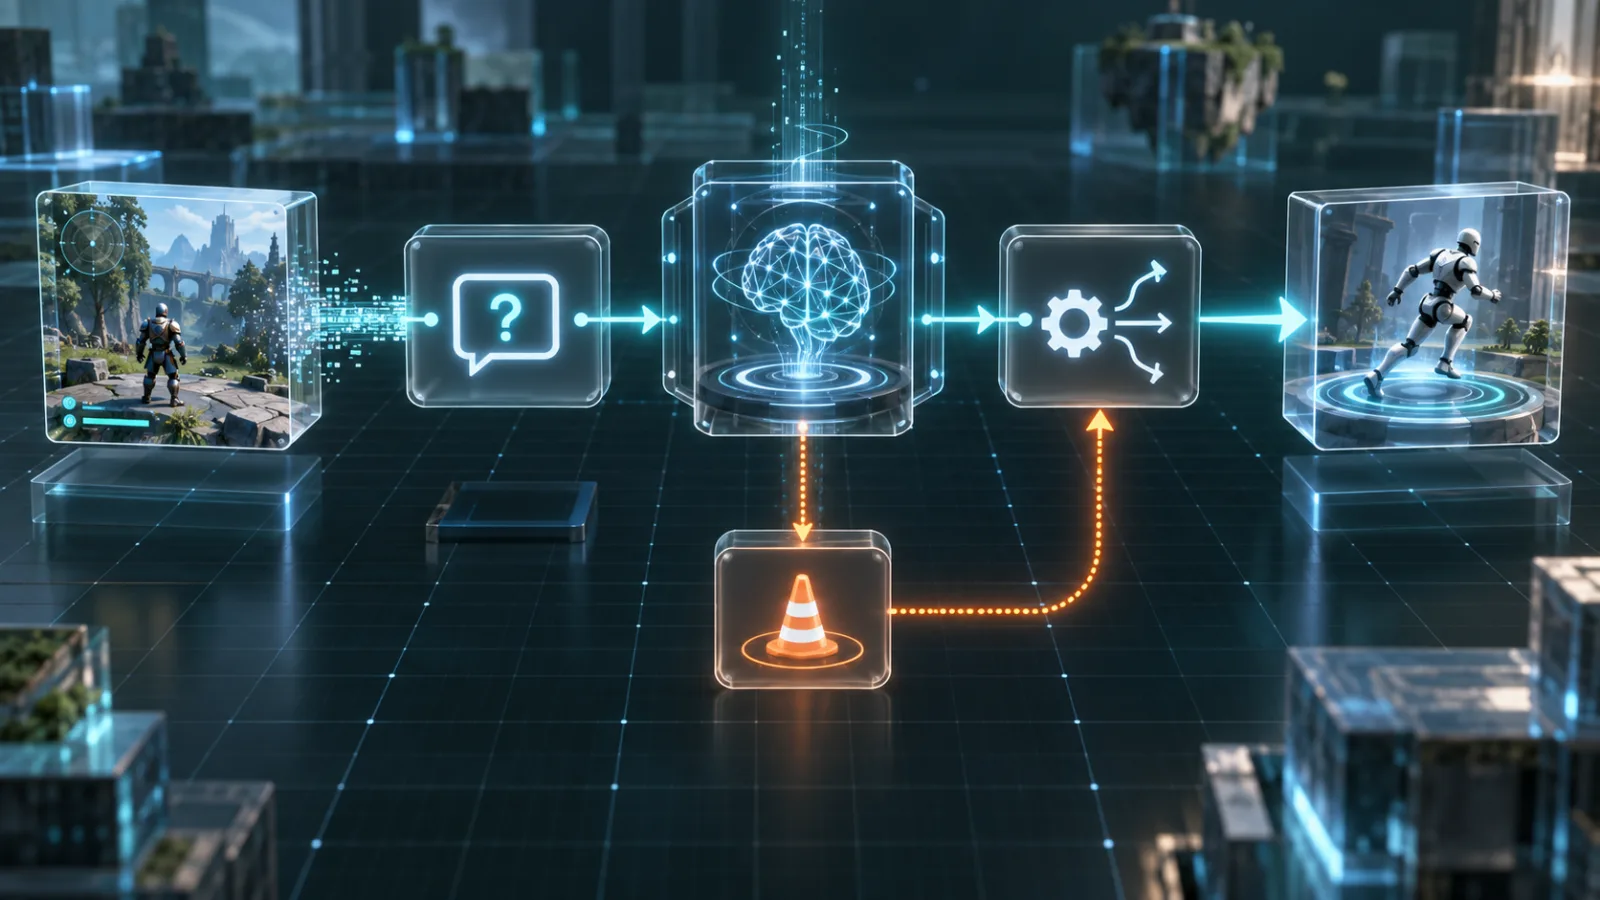
O Jev recebe duas coisas: o estado do programa (um ticket, os dados de uma nota, a tela de um site) e uma lista de perguntas com respostas possíveis definidas de antemão. Ele responde a todas de uma vez, em uma única consulta.
As três perguntas que o Jev sabe responder
- Escolha (choice): qual opção de uma lista é a certa. Exemplo: este chamado vai para financeiro, suporte técnico ou comercial? O Jev aceita até 255 opções por pergunta.
- Pontuação (score): um número dentro de uma escala. Exemplo: qual a urgência deste e-mail de 0 a 1?
- Sim ou não (noul): a probabilidade de uma afirmação ser verdadeira, de 0 a 1. Exemplo: esta resposta do chatbot resolve o pedido do cliente?
Toda resposta vem com uma probabilidade, e as de escolha e pontuação trazem também uma estimativa de confiança. Com isso, o sistema pode agir sozinho quando a confiança é alta e mandar o caso para um humano quando é baixa.
O que muda por dentro
- Amostragem paralela: um modelo de linguagem gera um token por vez, cada um dependendo do anterior. O Jev calcula todas as saídas ao mesmo tempo, o que explica boa parte da velocidade.
- Saída tipada: como as respostas possíveis são definidas antes, o Jev nunca devolve algo fora do formato. Não existe JSON quebrado nem categoria inventada.
- Treinamento próprio: a TypeSafe criou o método RLCD (Reinforcement Learning for Calibrated Decisions). Em vez de premiar respostas que agradam avaliadores humanos, como no RLHF, ele premia probabilidades honestas: quanto maior a confiança, maior deve ser a taxa de acerto.
Uma forma simples de resumir, que aparece em várias análises: um LLM escreve, o Jev decide.

Jev x LLMs: qual a diferença na prática?
O Jev não concorre com ChatGPT, Claude ou Gemini na conversa. Ele ocupa outra camada da automação, e a tabela abaixo mostra por quê.
| Critério | LLMs (ChatGPT, Claude, Gemini) | Jev |
|---|---|---|
| O que entrega | Texto livre: respostas, código, resumos | Decisão tipada: escolha, nota ou sim/não |
| Como gera a resposta | Um token por vez, em sequência | Todas as saídas de uma vez, em paralelo |
| Formato | Precisa ser lido e validado pelo sistema | Sempre dentro do formato definido |
| Confiança | Tende a ser excessiva e inconsistente | Probabilidade calibrada em toda resposta |
| Tempo de resposta | De segundos a minutos | 70 ms a 500 ms, segundo a TypeSafe |
| Preço de entrada | US$ 0,20 a US$ 10 por milhão de tokens | US$ 0,042 por milhão de tokens; saída gratuita |
| Melhor uso | Chat, copilotos, código, criação de conteúdo | Classificar, rotear, pontuar, filtrar e verificar |
Fonte: comparativo publicado pela TypeSafe no lançamento. Os dados do Jev são da própria empresa.
Na prática, os dois tendem a trabalhar juntos: o Jev classifica e encaminha a maior parte dos casos, regras fixas resolvem o que for simples e um LLM maior fica só com a minoria difícil.
Os números do lançamento (e o que eles não dizem)
A manchete da TypeSafe é forte: em seus testes de fluxos de trabalho, o Jev foi até 193,6 vezes mais rápido e 444,6 vezes mais barato que os LLMs comparados. A própria empresa, porém, publicou ressalvas que vale a pena ler junto com os números.
- São números de teto. A TypeSafe diz esperar que esses ganhos estejam no limite superior do que se verá no mundo real.
- Os testes foram feitos pela equipe da empresa. Ela afirma que os fluxos não foram montados para favorecer o Jev, mas reconhece que pode haver viés.
- A referência são outros modelos. A "resposta certa" dos testes foi a média do GPT-6 Astra e do Claude Fable 5.1, não uma verdade verificada por humanos.
- "Não alucina" significa "nunca sai do formato". O Jev não inventa uma categoria fora da lista, mas pode escolher a opção errada dentro dela. Errar continua possível.
- O preço pode mudar. A TypeSafe admite que não consegue provar que o valor atual não é subsidiado.
O que dá para conferir com facilidade são a velocidade e o custo por chamada. A comparação também só faz sentido para decisões que hoje são entregues a um LLM dentro de um sistema. Para escrever um texto ou um código, o Jev simplesmente não se aplica.
Onde o Jev pode ser usado
O Jev rende mais em decisões repetitivas e em grande volume, aquelas que hoje exigem uma pessoa olhando caso a caso ou um LLM caro respondendo em JSON. A TypeSafe aponta como maior oportunidade processos como classificar pedidos de atendimento, avaliar notas fiscais, triar alertas de segurança e revisar o trabalho de agentes de IA (SiliconANGLE).
| Área | Pergunta que o Jev responde | Ganho esperado |
|---|---|---|
| Atendimento | Para qual equipe vai este chamado? Qual a urgência? | Triagem instantânea, sem fila manual |
| Financeiro | Esta nota fiscal tem algo fora do padrão? | Revisão humana só nos casos suspeitos |
| Vendas | Este lead tem perfil de compra? | Priorização automática da carteira |
| Agentes de IA | Qual ferramenta o agente deve chamar agora? Esta ação é segura? | Roteamento barato e uma camada de segurança |
| Avaliação de IA | Esta resposta do chatbot resolve o pedido? | Monitoramento de qualidade em escala |
| Tempo real | Qual a próxima ação em um jogo ou em uma página web? | Decisões em milissegundos |
A linha de vendas é um exemplo ilustrativo; as demais vêm dos casos citados pela TypeSafe e de suas demonstrações. Essas demonstrações incluem um bot que joga Doom com cerca de 10 consultas por segundo, a um custo estimado de US$ 7 por hora, e um agente que navega pela Wikipédia escolhendo entre centenas ou milhares de links a cada passo.
O que isso significa para pequenas empresas
Pouca gente vai integrar o Jev diretamente. O efeito mais provável é indireto: sistemas de gestão, plataformas de atendimento e ferramentas de automação passam a embutir decisões de IA baratas em tarefas que antes eram manuais ou caras demais para automatizar. O movimento já começou, com integrações em plataformas como Cloudflare Workers AI, Vercel e Arize.
Limites e críticas
O Jev chamou atenção rapidamente, e as análises independentes já apontam onde é preciso ter cuidado.
- Viés escondido em um número. Uma nota ou probabilidade não mostra como o modelo chegou a ela, e vieses podem passar despercebidos. Usos sensíveis, como triagem de candidatos a vagas, pedem cautela redobrada. O lado bom é que, como cada chamada custa frações de centavo, dá para rodar milhares de testes para auditar o modelo antes de usá-lo.
- Calibração precisa ser testada nos seus dados. A confiança só vale se, no seu caso, 90% de confiança realmente significar cerca de 90% de acerto (SiliconANGLE).
- Pouca evidência independente. O The Register observa que ainda há poucos benchmarks externos sobre a inteligência do Jev.
- Não substitui um LLM. O Jev não escreve, não resume e não explica. Ele também não lê imagens por enquanto: as demonstrações usam dados estruturados com texto.
- Versões que mudam sozinhas. O apelido
jev-latestaponta sempre para a versão mais recente. Em produção, o recomendado é fixar uma versão testada, comojev-1.13. - Decisões de alto impacto pedem supervisão. O próprio desenho de uso proposto coloca o Jev dentro do código, cercado de regras de negócio, permissões e revisão humana.
Para empresas brasileiras, vale somar duas questões práticas: o serviço roda nos Estados Unidos, o que afeta a latência, e enviar dados de clientes para uma API externa exige atenção à LGPD.
Como começar a usar o Jev
O Jev estreou em 15 de setembro com lista de espera, mas a TypeSafe abriu o acesso para todos menos de uma semana depois (Crypto Briefing). Para quem quer testar, o caminho é este:
- Crie a conta em typesafe.ai e gere uma chave de API no console.
- Escolha uma decisão repetitiva do seu fluxo: triagem de chamados, classificação de leads ou checagem de documentos são bons pontos de partida.
- Defina as perguntas e as respostas possíveis. Quanto mais claras e independentes, melhor o resultado.
- Compare com o que você usa hoje. Rode o Jev em casos já resolvidos e confira se a confiança bate com a taxa de acerto real.
- Defina limites de confiança. Acima de um valor, o sistema age sozinho; abaixo, o caso vai para uma pessoa.
- Fixe a versão do modelo antes de colocar em produção.
A TypeSafe oferece SDKs em Python e JavaScript. O modelo também já pode ser chamado por plataformas como Vercel e Cloudflare Workers AI e por gateways como o OrcaRouter.
Perguntas frequentes sobre o Jev
O Jev substitui o ChatGPT ou o Claude?
Não. O Jev não gera texto, então não serve para conversar, escrever ou programar. Ele complementa os LLMs, assumindo as decisões rápidas para que o modelo maior trabalhe só onde é necessário.
O Jev é gratuito?
Não, mas é barato: US$ 0,042 por milhão de tokens de entrada, e a saída não é cobrada, segundo a TypeSafe. Contas novas recebem US$ 5 em créditos para testar.
É verdade que o Jev não alucina?
Em parte. Ele nunca responde fora das opções definidas, então não inventa categorias nem quebra o formato. Mas pode escolher a opção errada, por isso a confiança de cada resposta deve ser monitorada.
Quem criou o Jev?
A TypeSafe AI, laboratório de São Francisco fundado em 2024 por Diogo Almeida, ex-pesquisador da OpenAI, com Erik Gafni e Sasha Sheng. O lançamento foi em 15 de setembro de 2026.
